Les points clés à retenir sur l'IA en local avec l'OmniBook Ultra de HP
- Les PC équipés de l’architecture Nvidia RTX Spark sont exceptionnels pour les tâches d’IA.
- L’exécution d’un modèle à poids ouverts en local n’entraîne aucun coût par token ni aucune limite d’utilisation.
- Le principal avantage de l’exécution d’un modèle d’IA en local réside toutefois dans la confidentialité.
À l’aube de l’ère des PC, Bill Machrone, le légendaire rédacteur en chef de PC Magazine, a formulé la loi de Machrone : « L’ordinateur que vous voulez coûtera toujours environ 5 000 euros. » Ce chiffre est peut-être un peu plus élevé aujourd’hui en raison de la crise actuelle de la mémoire vive. Mais si l’on tient compte de l’inflation, la loi de Machrone reste d’actualité.
La preuve ? J’ai en ce moment même sur mon bureau un ordinateur portable à 7 000 euros. Et je dois avouer que je le veux vraiment, vraiment.
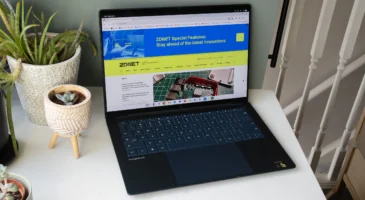
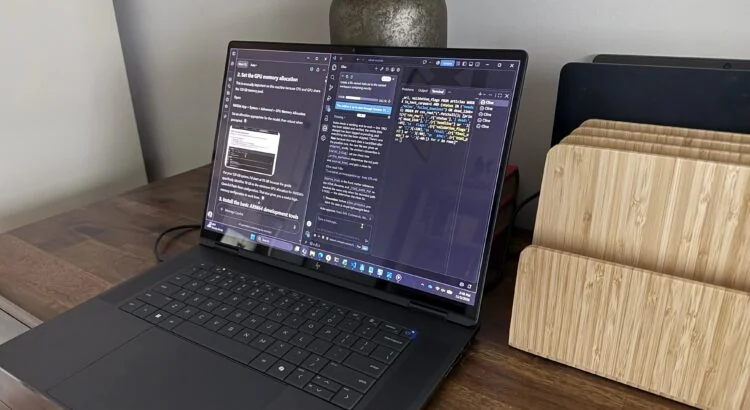
L’HP OmniBook Ultra est une véritable bête de course. Il est équipé d’un processeur Nvidia RTX Spark, de 128 Go de mémoire unifiée, de 2 To de stockage NVMe Gen5 ultra-rapide et d’un superbe écran OLED de 16 pouces. Il pèse près de 2,3 klios.
Je ne fais pas partie du public cible de cet ordinateur
Mais il s’agit moins d’un ordinateur portable que d’un véritable centre de données personnel, offrant une puissance de calcul IA FP4 de 1 pétaflop.
Je ne fais pas partie du public cible de cet ordinateur. Mais après l’avoir utilisé pendant quelques semaines, je suis sérieusement tenté. Pour les tâches liées à l’IA, son GPU est bien plus puissant que celui d’un PC Copilot+ standard. Et il est capable de tirer pleinement parti de la mémoire unifiée.
Cet ordinateur m’a enfin permis de m’attaquer à un projet qui figurait sur ma liste de tâches depuis des années : créer un index entièrement consultable regroupant 20 ans de mes articles publiés ici, sur ZDNET. Grâce à un puissant modèle d’IA local, ce PC a accompli cette tâche en une seule journée, sans me coûter un centime en frais d’abonnement à l’IA ni envoyer mes données vers le cloud d’un tiers.
Comment l’IA locale a mené mon projet à bien en un clin d’œil
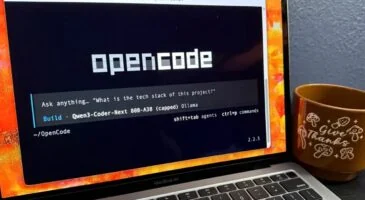
L’une des raisons pour lesquelles mon projet a été mené à bien si rapidement est que j’ai pu l’exécuter sans interruption. J’ai utilisé Copilot pour m’aider à configurer l’environnement de travail au départ, en utilisant le runtime d’inférence open source llama.cpp, le grand modèle linguistique Qwen3.8-27B à poids ouverts, et un framework de codage appelé Cline, fonctionnant comme une extension dans Visual Studio Code.
Avec un petit coup de pouce supplémentaire de Copilot, j’ai configuré ces outils, rédigé un cahier des charges détaillé pour l’application que je souhaitais créer, je l’ai transmis à Cline, puis je me suis contenté, pour l’essentiel, de prendre du recul et d’observer.
J’avais une bonne idée générale de ce que faisaient tous ces composants, mais il m’aurait fallu des semaines de lecture, d’étude et d’installation manuelle par essais et erreurs pour tout mettre en place et faire fonctionner le tout. Grâce aux scripts PowerShell rédigés par Copilot, j’ai pu lancer le projet en moins d’une demi-heure.

Lire les commentaires en direct pendant que l’agent de codage « réfléchissait » était parfois hilarant. Capture d’écran par Ed Bott/ZDNET
J’ai pu observer l’IA « raisonner » en temps réel
Au fur et à mesure que le projet avançait, j’ai pu observer l’IA « raisonner » en temps réel. De temps à autre, elle me demandait de valider quelque chose, mais la plupart du temps, elle écrivait du code, effectuait des tests, observait les résultats, modifiait le code, effectuait d’autres tests, et ainsi de suite. L’ensemble du processus était un exemple parfait de « codage agentique avec intervention humaine », et tout ce que j’avais à faire était de vérifier de temps à autre comment les choses se passaient.
Je savais qu’elle était occupée, car lorsque le LLM fonctionnait, j’entendais le ventilateur tourner depuis l’autre bout de la pièce. Étonnamment, la machine ne chauffait jamais au point de devenir inconfortable. Néanmoins, c’est le genre de travail qu’il vaut mieux effectuer avec l’ordinateur portable posé sur un bureau, et non sur les genoux.
J’ai fourni au LLM une feuille de calcul remplie de liens vers mes articles, que j’avais minutieusement constituée au cours des deux dernières années.
Je ne saurais vous dire à quel point ce résultat m’a réjoui
Non seulement il a trouvé et récupéré presque tous les articles de cette liste, mais il a également mis au point une routine distincte pour récupérer des pages à partir de la Wayback Machine d’Internet Archive pour environ 90 liens qui renvoyaient des erreurs 404, puis m’a présenté une liste d’environ 90 autres pages qu’il n’avait pas pu récupérer du tout. Il m’a fallu environ 30 minutes pour examiner et résoudre cette dernière série de problèmes.
Une fois tout cela terminé, je me suis retrouvé avec deux dossiers, contenant chacun 1 951 fichiers — l’un au format HTML brut, l’autre au format Markdown. Et pour finir, j’ai demandé à mon IA locale de créer un script simple que je peux exécuter pour ajouter de nouveaux articles à l’archive au fur et à mesure de leur publication.
Je ne saurais vous dire à quel point ce résultat m’a réjoui.
Combien cela a-t-il coûté ?
Le projet complet a utilisé 479 appels d’inférence LLM et traité près de 50 millions de tokens logiques, pour un coût net total de exactement 0,00 €.
L’un des aspects les plus frustrants de l’utilisation de ces outils de codage IA modernes est qu’il n’y a aucun moyen d’estimer le nombre de tokens qu’ils vont utiliser.
J’aurais pu recourir à un abonnement IA commercial pour réaliser ce travail. Mais j’aurais avancé à l’aveuglette. Aucune des entreprises qui proposent ces formules ne peut vous dire combien coûtera un projet donné. Votre consommation réelle — et donc la facture finale — dépend de facteurs que vous ne pouvez pas connaître à l’avance. Quelle quantité de code l’agent doit-il garder en mémoire ? Combien d’itérations et de cycles de débogage seront nécessaires ? Quels modèles utiliserez-vous ?
« Les 5 % d’utilisateurs les plus actifs de Claude Code dépensent en moyenne 18 000 dollars par an »
ChatGPT Plus (avec Codex), Claude Code Pro ou GitHub Copilot coûtent tous entre 10 et 20 dollars par mois. C’est largement suffisant pour une tâche simple, mais pour ce projet, j’aurais rapidement atteint les limites d’utilisation avec ces formules d’entrée de gamme. Pour continuer à travailler avec une formule à 20 dollars par mois, j’aurais dû faire de fréquentes pauses, acheter des crédits supplémentaires ou passer à une formule à 100 dollars par mois offrant des limites d’utilisation plus élevées, comme ChatGPT Pro, Claude Code Max ou GitHub Copilot Max.
En examinant ces chiffres, j’ai compris où s’orientaient les modèles économiques d’Anthropic, d’OpenAI et de Microsoft. Même à 100 $ par mois, si j’avais décidé de mener des projets encore plus ambitieux, j’aurais facilement pu me retrouver soumis à des limitations de débit, mon travail devant alors attendre des heures, voire des jours, jusqu’au début du cycle suivant.

L’ordinateur portable phare de Microsoft, le Surface Laptop Ultra équipé de la technologie RTX Spark – Kyle Kucharski/ZDNET
Pour les codeurs chevronnés, ces factures peuvent s’avérer très coûteuses. Lors d’un récent épisode du podcast Decoder de Nilay Patel, l’analyste Joey Brookhart a révélé une statistique surprenante : « Les 5 % d’utilisateurs les plus actifs de Claude Code dépensent en moyenne 18 000 dollars par an. Les utilisateurs qui n’utilisent pas Claude Code dépensent bien moins de 75 dollars par mois. »
Je comprends désormais pourquoi.
Le plus grand avantage de tous
L’utilisation d’un modèle gratuit à poids ouverts, associé à un harnais de codage open source, vous offre la liberté d’expérimenter sans vous soucier de la facture. Mais ce n’est qu’une partie de l’histoire.
L’avantage bien plus important est que vous n’envoyez pas de données potentiellement sensibles ou confidentielles vers le cloud d’un tiers.
Grâce à une pile d’IA entièrement locale, vos prompts, vos documents et vos charges de travail d’inférence n’ont pas besoin de quitter votre PC.
Mais le prix alors, c'est un problème ?
Ce n’était pas un problème pour mon projet, qui utilisait du contenu déjà publié sur le Web. Mais j’ai en tête quelques autres applications que je préfère ne partager avec personne d’autre tant qu’elles ne sont pas prêtes. L’une d’elles implique une grande quantité de documents financiers, de relevés de carte bancaire et de factures. Je suis tout à fait disposé à alimenter un LLM avec ces données sur mon propre PC, mais je ne me sens pas à l’aise à l’idée de télécharger ces documents vers un service de codage hébergé dans le cloud.
Est-ce que je vais avoir suffisamment de travail de ce type pour justifier de dépenser 7 000 euros dans un PC ? J’aimerais bien répondre oui. Mais mon expert-comptable se contenterait de me fixer du regard pendant une bonne minute avant de m’expliquer patiemment comment fonctionne le « retour sur investissement ». « Non, Ed, tu ne peux pas justifier cette dépense. »
La bonne nouvelle, c’est que la loi de Machrone va de pair avec la loi de Moore, qui décrit une tendance technologique fiable : la puissance de calcul double tous les 18 mois environ. Cela signifie que d’ici trois ans, je pourrai rêver d’un PC quatre fois plus puissant pour 7 000 euros. Mais d’ici là, une configuration comme celle de cet HP OmniBook Ultra sera probablement devenue un ordinateur professionnel courant, disponible pour une fraction de son prix actuel.
D’ici là, je vais attendre.
Source : "ZDNet.com"